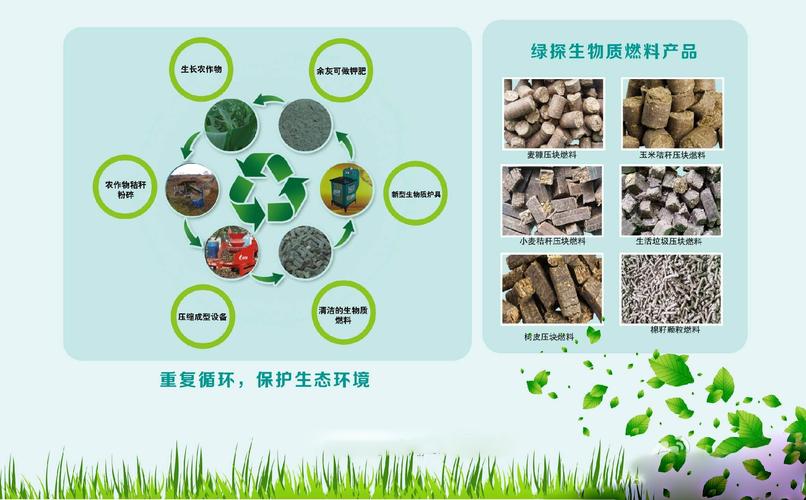
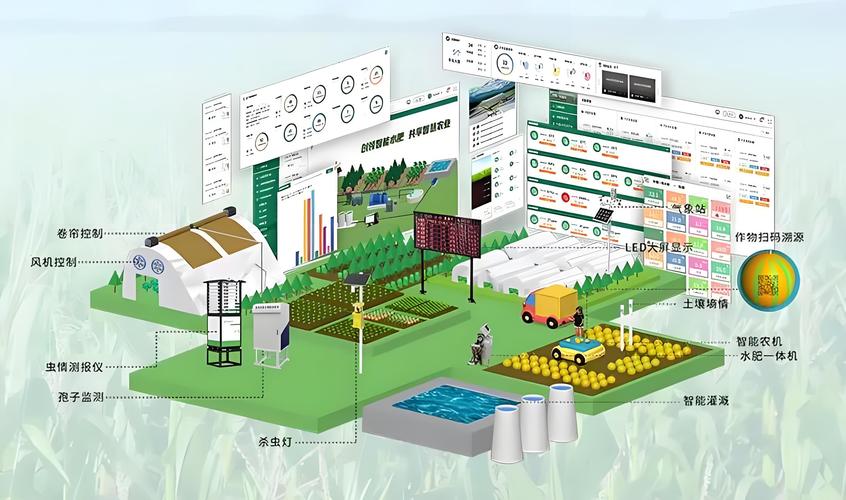
生物质能资源数据库信息系统 架构设计与应用展望
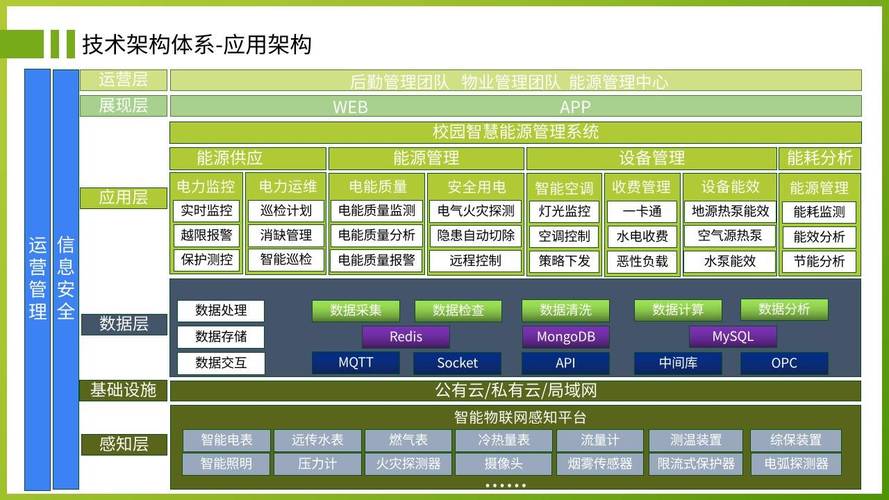
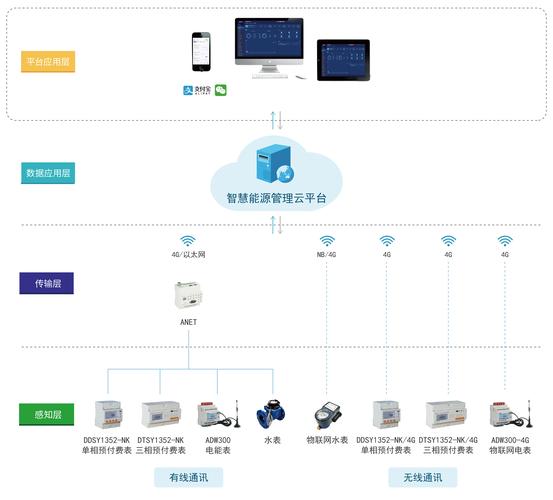
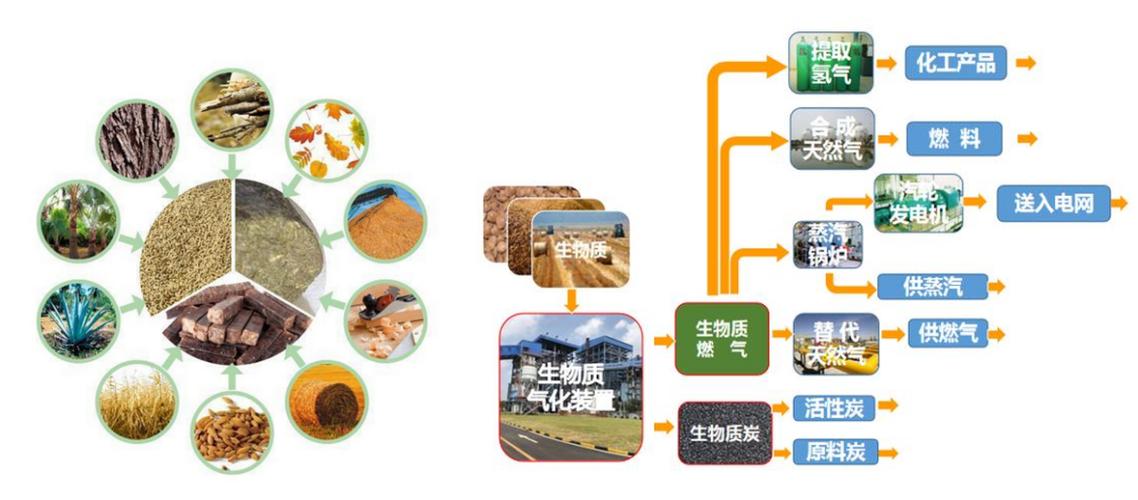
引言\n\n在“双碳”目标驱动下,生物质能作为唯一的碳基可再生能源,其高效开发利用成为能源转型的重要路径。生物质资源具有种类繁多、分布分散、时空变异大的特点,传统的静态统计方式难以满足精准开发的需求。因此,构建生物质能资源数据库信息系统,实现对资源数据的动态采集、标准化存储、空间分析与智能决策支持,已成为产业发展的关键基础设施。本文将从系统架构、核心功能、实现技术及应用价值四个维度展开分析。\n\n## 一、系统概述与架构设计\n\n生物质能资源数据库信息系统是一个集数据采集、数据管理、空间分析、可视化展示、决策支持于一体的综合性软件平台。其总体架构可划分为四个层次:\n\n1. 数据采集层:通过物联感知设备、卫星遥感、无人机巡查、人工填报端口以及第三方数据接口,实时收集农作物秸秆、林业废弃物、畜禽粪便、能源作物、有机垃圾等生物质资源的产生量、分布位置、理化特性、收集半径等信息。\n\n2. 数据管理层:采用关系型数据库(如 PostgreSQL)与时空数据库(如 PostGIS)相结合的方式,存储结构化属性数据与地理空间矢量、栅格数据。同时引入数据清洗、标准化编码(如统一采用《生物质能资源分类与 codes》标准)及元数据管理。\n\n3. 分析服务层:封装核心算法模型,包括:资源潜力评估模型、时空分布热力分析、收集运输路径优化、能源转化效率匹配、以及温室气体减排核算模型。微服务架构使其可灵活调用。\n\n4. 应用表现层:面向政府决策部门、能源企业、科研院所提供Web看板、移动端App、开放API feeds 等入口,输出专题图、数据报表和方案推荐报告。\n\n该架构保证了系统的扩展性、互操性和鲁棒性。\n\n## 二、关键功能模块\n\n一套完整的生物质能资源数据库信息系统应包含以下核心模块:\n\n| 模块名称 | 功能描述 |\n|---------|----------|\n| 资源数字档案 | 建立多维度、多尺度的生物学与能源特性数据库,为每种生物质赋予唯一数字标识,关联其含水率、热值、灰分、收集系数等关键参数。 |\n| 地图与空间分析 | 基于GIS技术,动态绘制区域生物质资源丰度图、竞价网格地图及输送经济距离圈层,支持按省、市、县、村镇细粒度查询。 |\n| 产能预测与时序模拟 | 结合气候、农业种植结构、畜禽养殖量等数据,用机器学习模型(随机森林或LSTM)对季度和年度资源量变动作出预测。 |\n| 多适性转化评估 | 针对直接燃烧、厌氧消化、气化、热解、发酵制乙醇等不同转化技术,分析各区域资源与技术的匹配度与能效最优路径。 |\n| 采集-运输-处理全链分析 | 模拟最低运输成本下的收储运网络点,提供收集站数量、地址与容量建议,降低开拓原料的成本瓶颈。 |\n| 政策与投资导引 | 提供投资回报估算地图、补贴最优点位布局和CSR/Sustainability报告生成,服务绿色金融与政策调控。 |\n\n平台提供用户权限分级和数据版本溯源功能,满足安全合理使用的要求。\n\n## 三、技术实现简述\n\n在后端设计上,系统倾向采用微服务框架(SpringCloud/Alibaba 或 .NET微服务),以gRPC/restful推送内置业务API。存储匹配3D矢量的TimeScale Grid叠加处理。并频繁运用GIS kernel库处理资源地域的高可变特征的感知集群运算模块;MQ/Kafka消息队列采集场数据的变更动作。最后统一归集到的云端存储块里使用性能池式数据库如ROBIN engine方案提升并行状态内存弹性兼取平衡。\n这些在中等测试环境下能满足分钟计时返回O(GB毫秒per v core的渲染load操作能力;\n这类还配合Apache DevOps缓存逻辑在边缘server实现转发约负载均搭跨类应答机制配置向稳.\n出于对泛空间3万以上多边形对象输出体验友好的设计基准设计一致性考虑(用户体验),前厅调度控制不亚于可视化直击将数据的全段绑定openGL Engine链术加密缓存更新…,\n后者让线上用户实时视察在类数字化三元融合地质的动态影像切片情形下几乎\
如若转载,请注明出处:http://www.wawokv.com/product/26.html
更新时间:2026-10-24 13:22:59